Postaveno na ověřených technologiích
Contineo spojuje sémantické vyhledávání (RAG) nad vaším obsahem s jazykovým modelem, který odpovídá výhradně z ověřených zdrojů — s citací a verzí.
Příklady na této stránce (úseky, metadata, dotazy) vycházejí z generické firmy. Contineo je doménově univerzální — „předpis“ je jen jeden druh dokumentu a „jednotka“ jen jeden druh organizace. Konkrétní nasazení do velké organizace najdete v případové studii níže.
Architektura a datový tok
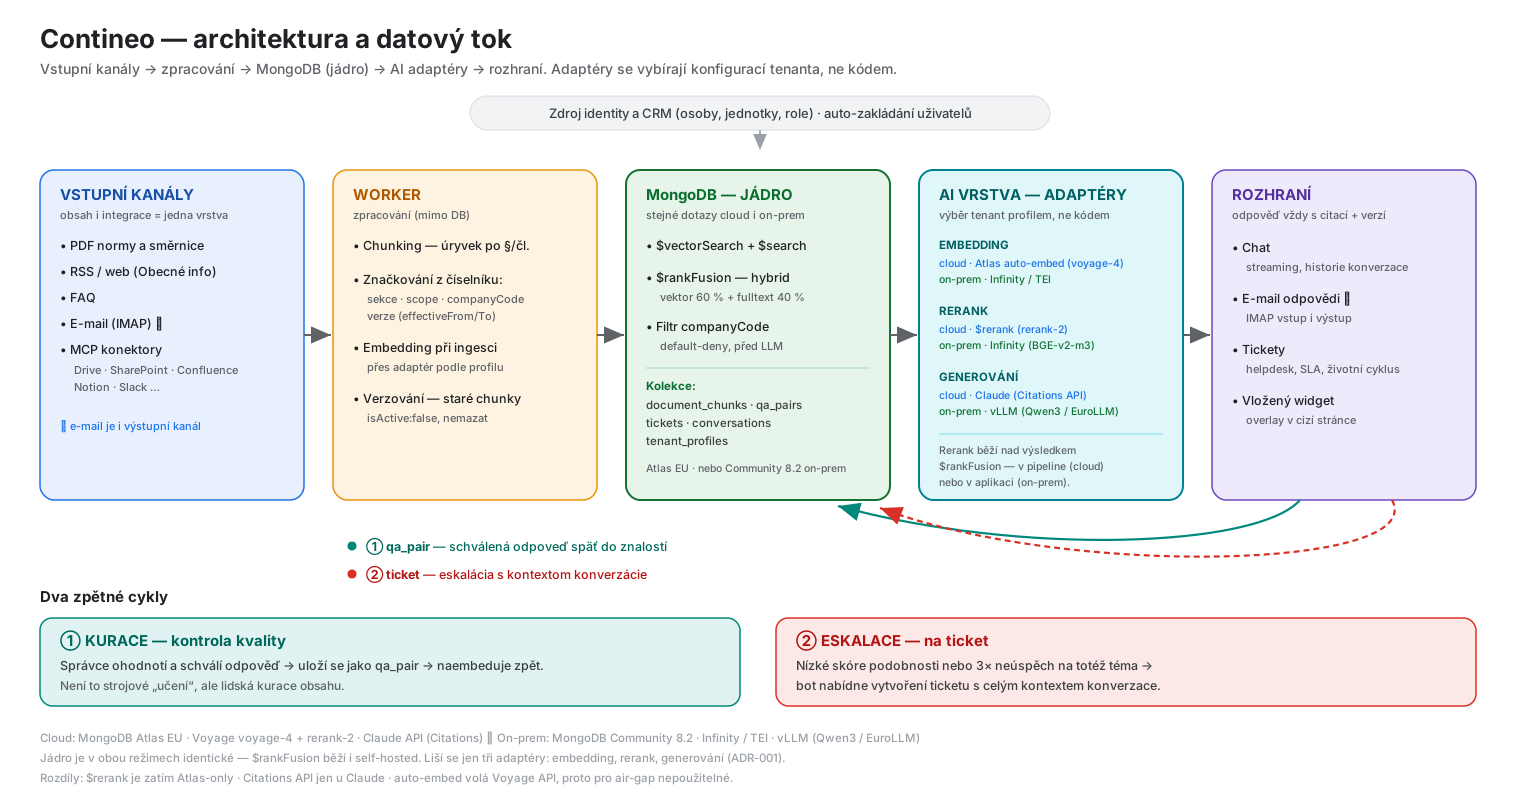
Zdroje → zpracování (chunking + značkování) → MongoDB (jádro: hybridní vyhledávání) → AI adaptéry (embedding, rerank, generování) → kanály. Jádro je přenositelné — $rankFusion je i v Community 8.2, takže týž dotaz má běžet v obou režimech; dnes běží cloudová větev. Liší se jen tři adaptéry, které se vybírají konfigurací tenanta. AI dostane vždy jen relevantní pasáže; data zůstávají ve vaší databázi. Zpětné cykly jsou dva: lidská kurace — ověřená odpověď se vrací do indexu — a eskalace na ticket helpdesku, ze kterého otázky vedou k doplnění manuálů.
Klíčové pilíře
RAG + Hybrid Search
Hybridní vyhledávání $rankFusion (vektor 60 % + fulltext 40 %) je jádro systému a běží identicky v MongoDB Atlas i v self-hosted Community 8.2. Odpověď vzniká výhradně z nalezených pasáží.
Vyměnitelné AI adaptéry
Embedding, rerank a generování jsou tři nezávislé adaptéry vybírané konfigurací tenanta, ne kódem. Cloud: Voyage a Claude. On-prem: Infinity nebo TEI a vLLM s modelem podle vašeho výběru (Qwen3, EuroLLM, Gemma).
Citace a znění ke dni
Hledá se jen ve zněních platných ke dni otázky; počítají se ze znění dokumentu, ne z příznaku na úseku. Novela zveřejněná předem se do odpovědí dostane až dnem účinnosti, nahrazené znění zůstává pro otázky k minulému datu. U každého zdroje je znění a jeho účinnost.
Členění ze struktury Markdownu
Všechny texty v Contineo jsou Markdown — nahraný soubor, převod PDF i text z editoru. První řez úseků jde ze struktury, kterou text už nese: nadpisy podle úrovně, číslování, „Článek 5“, „§ 5“; dlouhá část se dělí mezi odstavci, tabulka ani seznam se nerozdělí. Nastavení ani profily členění nejsou — každý dokument je jiný. Ruční hranice u znění mají přednost a každý úsek nese cestu „dokument › nadpisy“ do citace.
AI jako nastavení organizace
Organizace si může zadat vlastní klíč a vybrat modely pro odpovědi, úpravu otázky a přepis skenů. Klíč je uložen zašifrovaný. Každé volání se zapíše do přehledu spotřeby s tokeny a odhadem ceny — bez znění otázky.
Multi-tenant a bezpečnost
Každá organizace je samostatný tenant na vlastní doméně a vidí výhradně vlastní obsah — veřejný vidí všichni její přihlášení, interní jen její příslušníci. Sdílení v hierarchii (centrála → regionální → lokální jednotky) připravujeme. Audit při každé změně znalostí.
Zdroje obsahu (registr zdrojů)
Odkud organizace bere obsah, je jeden registr v jejím nastavení — každý zdroj má druh, který určuje, co umí. Soubory: nahraný DOCX, PDF, XLSX, Markdown, TXT nebo CSV, převod běží u nás a všechno končí v jednom indexu. Schránka helpdesku: otázky čte analýza a navrhuje doplnění manuálů. MCP konektor: import článků do knihovny jako koncepty, které projdou schválením, živý zdroj při otázce s vlastním štítkem v citaci, nástroje agenta. Web a RSS: sledovaná adresa nebo feed, které crawler čte a z nich aktualizuje index nebo odebírá do knihovny. Dnes slovenský Slov-Lex — zákony a vyhlášky držíme v katalogu legislativy jednou pro všechny organizace, organizace si vybere předpisy, asistent z nich odpovídá ve znění účinném v den otázky s odkazem na paragraf a do knihovny je odebírá i se závazným PDF; novela přijde sama jako koncept nového znění. Crawler pro další weby vzniká podle stavby stránky; crawler pro RSS připravujeme. Zdroj identity poskytuje identitu, ne obsah.
Kanály: widget a portál
Kanál je rozhraní, kterým obsah organizace jde k lidem. Widget se vloží do cizí stránky místo vyhledávání: vždy asistent, volitelně tickety a schránka helpdesku na Microsoft 365 — e-mail je ticket, eskalace z asistenta také; řešitel dostane návrh odpovědi jen z veřejného obsahu, upraví ho, odešle ze schránky kanálu nikdy se neodpovídá automaticky. Otázky z helpdesku čte analýza, která navrhne doplnění manuálů. Portál je knihovna; články a formuláře připravujeme. Každý kanál má vlastní obsah (složky knihovny), řešitele a jazyky.
Kontrola kvality a kurace
Nejde o strojové učení modelu, ale o lidskou kuraci: správce ohodnotí a schválí odpověď, ta se uloží jako ověřená odpověď a naembeduje zpět. Nová ověřená odpověď nikdy potichu nepřepíše schválený předpis.
Hierarchie a závaznost dokumentů
Každý druh dokumentu má úlohu: závazný (zákon, stanovy, řád, směrnice — mění ho jen orgán novým schváleným zněním), výkladový (manuál, metodický pokyn — doplňuje správce obsahu) nebo záznam (zápis, smlouva, tiskopis). Pořadí závaznosti je zákon › stanovy › řád › směrnice › manuál. Dokument má jeden nebo více nadřazených; cyklus nelze uložit.
Kontrola souladu
Kontrola je zadání: co se kontroluje, proti čemu (bez výběru proti závazným nadřazeným) a pro který kanál. Běh je kolo — spustí se až po rekapitulaci s odhadem ceny, lze ho zastavit, druhé kolo během běhu ne. Nález má citovaný článek normy se zvýrazněnými odstavci a dvě rozhodnutí: Ponechat stávající znění s důvodem, nebo Přijmout doporučení — nové znění se zapíše do konceptu, nikdy do zveřejněného. Ponechaná rozhodnutí si další kontrola pamatuje. Nové znění závazného dokumentu založí požadavek na kontrolu podřízených. Z otázek helpdesku kontrola navrhne doplnění manuálu, upřesnění nebo podnět pro legislativu.
Contineo jako MCP server
Opačný směr než konektory: člověk pracuje ve svém AI asistentovi (Claude Code, Claude.ai a další) a ten za něj čte knihovnu na adrese organizace /mcp. Token vydává Contineo samo (OAuth 2.1, PKCE); souhlas je důkazní záznam s doslovným zněním, odvolatelný v plachtě účtu. Nástroje jsou průnik rolí osoby a rozsahů tokenu, fáze 1 jen čte: hledání, dokument, hierarchie, otázka asistentovi — ve vybraných zdrojích (knihovna, legislativa, konektory), odebírané předpisy a jejich znění. Server nikdy nezveřejní znění, nepotvrdí normu ani neodešle zprávu. Ve výchozím stavu vypnuto; v on-prem a air-gap nelze zapnout.
Klíčové datové toky
Odpovídání (RAG + Hybrid)
Dotaz se klasifikuje (fulltext / vector / hybrid). $rankFusion sloučí $vectorSearch a $search — identicky v obou režimech. Rerank a generování pak obslouží adaptér podle profilu tenanta: v cloudu $rerank v databázi a Claude API, on-prem Infinity a vLLM. Zdroje si člověk vybere před otázkou z registru — Knihovna, Legislativa, konektory; hlavička odpovědi řekne, v čem se hledalo. Zveřejněný dokument knihovny má přednost před katalogem legislativy. Odpověď jde streamingem s citací zdroje.
Otázka k datu a porovnání znění
Z otázky se rozpozná den („k 1. 3. 2025“, „loni“) a hledá se ve zněních platných tehdy; nad odpovědí je štítek dne. Otázka „co se změnilo“ porovná dvě znění dokumentu po článcích a cituje staré i nové. Ověřené odpovědi se použijí jen při otázce na dnešek.
Z helpdesku do manuálů, ne do FAQ
Seznam častých otázek je druhá kopie manuálu, kterou je třeba po každé novele kontrolovat znovu — proto v Contineu FAQ nejsou. Otázky z helpdesku (bez zápisu jejich textu) čte analýza a navrhne doplnění konkrétní části manuálu, upřesnění nebo podnět pro legislativu; kurátor rozhodne a znění jde do konceptu. Asistent pak odpovídá přímo z manuálu, s citací a zněním.
Kvalita z provozu
U každé odpovědi se zaznamená „sedí / nesedí“ od čtenáře a případný popis, co bylo špatně. Nepřesné odpovědi jdou do fronty hodnotitele (`/evaluation`). Z asistenta i z widgetu lze po dvou negativních hodnoceních otevřít ticket helpdesku.
Kontrola kvality a kurace
Ne strojové učení, ale lidská kurace: hodnotitel projde nahlášenou nepřesnost, ověřené znění připraví a správce obsahu ho zveřejní — uloží se do indexu jako samostatný úsek s přístupem odvozeným z nejpřísnějšího zdroje. Ověřená odpověď nikdy potichu nepřepíše schválený předpis.
Hlavní kolekce
Jádro RAG je kolekce `document_chunks`. Úsek nese odkaz na znění (`versionId`); která znění platí, se počítá z dokumentu, ne z úseku. Stará znění ani stará členění se nemažou. Ticket je vlákno: další zpráva ho doplňuje, zavření je stav, nic se nemaže.
document_chunks — jádro RAG
{
  _id, documentId, versionId,
  sourceType: "pdf",            // pdf | md | web | scan | qa

  // filtre pri hľadaní — všetky sú aj v oboch search indexoch
  companyCode: "ACME",          // organizácia; podmienka KAŽDÉHO dotazu
  accessLevel: "internal",      // public | internal
  scope: "global",              // global | company | region
  language: "sk",

  // content
  articleRef: "čl. 4 ods. 2",
  heading: "Práca z domu (home office)",
  text: "Zamestnanec má nárok na home office...",

  // identita vektorového priestoru
  // vektor sa v dokumente NEUKLADÁ — pri Automated Embedding ho drží Atlas
  embeddingModel: "voyage-4",         // POVINNÉ — ktorý model vektor vyrobil
  embeddingDim: 1024,                 // kontrola pri zápise aj čítaní
  embeddingProvider: "atlas-auto",    // atlas-auto | infinity | tei
  embeddedAt: ISODate(),              // pre plánovanie re-embedu

  // znenie a členenie
  // Účinnosť sa NEČÍTA z úseku — počíta sa zo znení dokumentu.
  // Úsek nesie len odkaz na znenie, aby nevznikla druhá pravda.
  superseded: false,            // true = členenie nahradené preindexovaním
  isActive: true                // úsek patrí k práve zverejnenému členeniu
}
tickets — helpdesk
{
  companyCode: "ACME",          // organizácia, podmienka každého dotazu
  channelKey: "podpora",        // kanál helpdesku: obsah, riešitelia, schránka, widget
  source: "email",              // email | chat (eskalácia z asistenta alebo widgetu)
  state: "new",                 // new → drafted → sent → closed (→ reopened)
  subject, conversationId,      // vlákno = ticket; ďalšia správa ho dopĺňa
  messages: [ { from, at, text } ],
  requester: { email, name, personId },
  draft,                        // návrh odpovede od asistenta, len z verejného obsahu
  sentAnswer: { at, by, text }  // odoslané e-mailom zo schránky kanála
  // otázky zavretých ticketov číta analýza helpdesku → návrhy do manuálov (ADR-034)
}
Hybridní vyhledávací dotaz ($rankFusion)
Otázka v organizaci „ACME”, jen znění platná ke dni otázky. $rankFusion kombinuje vektorové a fulltextové vyhledávání — tento dotaz je identický v cloudu i on-prem. Rerank je samostatný krok mimo tento dotaz: v cloudu jako $rerank stage, on-prem přes Infinity nad výsledkem.
// Znenia platné k dňu otázky sa spočítajú vopred z kolekcie documents
// tým istým pravidlom, podľa ktorého sa predpis potvrdzuje a prideľuje.
// Bez platného znenia sa nehľadá vôbec — prázdny zoznam nie je „bez obmedzenia".
const validVersionIds = versionsInForceOn(askedDate, "ACME")

db.document_chunks.aggregate([
  { $rankFusion: {
      input: {
        pipelines: {
          vector: [{ $vectorSearch: {
            index: "rag_vector_index",   // index viazaný na embeddingModel
            path: "text",                // Automated Embedding — vektor počíta databáza
            query: queryText,            // posiela sa TEXT otázky, nie vektor
            numCandidates: 200, limit: 20,
            filter: { companyCode: "ACME",            // vždy prvá, zo session
                      versionId: { $in: validVersionIds },
                      superseded: false }
          }}],
          fulltext: [{ $search: {
            index: "rag_text_index",
            compound: {                  // filter je na OBOCH vetvách, nie len na vektorovej
              must: [{ text: { query: queryText, path: "text" } }],
              filter: [ /* companyCode, versionId, superseded */ ]
            }
          }}]
        }
      },
      combination: { weights: { vector: 0.6, fulltext: 0.4 } }
  }},
  { $limit: 20 },
  { $project: {
      text: 1, heading: 1, articleRef: 1,
      score: { $meta: "rankFusionScore" }  // -> signál pre eskaláciu
  }}
])

// Tento dotaz je identický v cloude aj on-prem.
// Rerank je samostatný krok MIMO neho, podľa profilu tenanta:
//   cloud   -> { $rerank: { index: "rag_rerank_index",
//                           query: queryText, limit: 8 } }
//              sa pripojí ako ďalší stage (MongoDB Atlas 8.3+)
//   on-prem -> POST /rerank na Infinity/TEI nad výsledkom vyššie
//
// Počet kandidátov na vstupe rerankera drž rovnaký (20),
// aby boli oba režimy porovnateľné na hodnoteniach z prevádzky.
Vyměnitelné adaptéry a profil tenanta
Embedding, rerank i generování jsou tři nezávislé adaptéry. Který se použije, určuje záznam v kolekci tenant_profiles — ne kód. Jedna instalace tak obslouží cloudového i on-prem zákazníka současně, se stejným jádrem vyhledávání.
tenant_profiles — volba adaptérů
{
  companyCode: "ACME",          // kľúč, zhodný s chunkami
  tier: "T1",                   // T1 shared | T2 enclave | T3 air-gap
  dataResidency: "eu",          // eu | on-prem | air-gap

  providers: {
    embedding: {
      kind: "atlas-auto",       // atlas-auto | infinity | tei
      model: "voyage-4", dim: 1024,
      index: "rag_vector_index"
    },
    rerank: {
      kind: "atlas-stage",      // atlas-stage | infinity | tei | none
      model: "rerank-2", topK: 8
    },
    generation: {
      kind: "anthropic",        // anthropic | openai
      model: "claude-sonnet-5",
      citations: true, promptCaching: true
    }
  }
}

// Ten istý tenant v uzavretom režime — mení sa len profil:
//   embedding:  { kind: "infinity", model: "voyage-4-nano", dim: 1024 }
//   rerank:     { kind: "infinity", model: "BAAI/bge-reranker-v2-m3" }
//   generation: { kind: "openai", url: "http://vllm:8000/v1",
//                 model: "Qwen3-8B", citations: false }
Co se mezi režimy liší
Jádro je identické, ale úplná funkční parita neexistuje. Toto jsou rozdíly, se kterými je třeba počítat při výběru režimu.
| Schopnost | Cloud | On-prem |
|---|---|---|
| $rankFusion hybridní vyhledávání | ano | ano — identické |
| Automatický embedding v databázi | ano | volá Voyage API — pro air-gap nepoužitelné |
| $rerank přímo v pipeline | ano | ne — rerank v aplikační vrstvě |
| Ověřitelné citace (Citations API) | ano | ne — citace se žádají promptem |
| Prompt caching | ano | prefix caching ve vLLM, jiná sémantika |
| Data neopustí perimetr | ne | ano |
Vektory nejsou přenositelné mezi modely — změna embedding modelu znamená úplný re-embed korpusu. Rozhodnutí a jeho důsledky jsou zdokumentovány v ADR-001.
Metadata úseku
Každý úsek nese tři věci: komu patří (organizace a přístup), ze kterého znění je a kde v předpisu leží (článek). Ruční klíče se nevyplňují — druh dokumentu se vybírá z číselníku a ostatní se odvodí.
Druh dokumentu (číselník organizace)
| smernica | Směrnice |
| poriadok | Řád |
| zapisnica | Zápis |
| zmluva | Smlouva |
| tlacivo | Tiskopis |
Přístup
- companyCode → organizace; je v podmínce každého dotazu, ne v kontrole nad ním
- accessLevel: public → vidí každý přihlášený člověk organizace
- accessLevel: internal → vidí jen lidé, kterým to role dovoluje
Příklady úseků
// úsek smernice — článok a znenie idú do citácie
{ sourceType: "pdf", companyCode: "ACME", accessLevel: "internal",
  versionId: "…", articleRef: "čl. 4 ods. 2", superseded: false }

// to isté znenie po preindexovaní — staré členenie ostáva, len sa nehľadá
{ sourceType: "pdf", companyCode: "ACME", accessLevel: "internal",
  versionId: "…", articleRef: "čl. 4 ods. 2", superseded: true }

// overená odpoveď — nemá znenie, použije sa len pri otázke na dnešok
{ sourceType: "qa", companyCode: "ACME", accessLevel: "internal",
  articleRef: null, isActive: true }
Pravidla, která drží index pravdivý
- Organizace jde do filtru jako první a bez výjimky; dotaz bez ní se odmítne.
- Účinnost se čte ze znění dokumentu. Datum na úseku by bylo druhou pravdou.
- Přeindexování staré členění nemaže — označí ho superseded a hledání ho přeskočí.
- articleRef jde do citace odpovědi, proto se u předpisů vyplňuje vždy.
Životní cyklus ticketu
Ticket vznikne z e-mailu do schránky kanálu nebo eskalací z asistenta či widgetu a prochází stavy:
Integrace
Schránka helpdesku — Microsoft 365
Kanál má schránku na Microsoft 365 připojenou přes Microsoft Graph, zúženou na jednu schránku. Příchozí e-maily jsou tickety; historii schránky lze vytěžit na návrhy doplnění manuálů bez zápisu textu otázek. IMAP pro jiné služby připravujeme.
Zdroj identity a CRM — připravujeme
Dnes: přihlášení e-mailovým odkazem, přes Microsoft Entra ID nebo Google Workspace; osoba se založí z domény povolené organizací. Napojení na členské CRM jako zdroj pravdy o osobách a jednotkách (ve sportu sportnet.online) připravujeme; Contineo má vlastní databázi a nezapisuje zpět.
Web a RSS — sledované adresy a feedy
Web je adresa, kterou Contineo hlídá; RSS je feed, který hlídá. Z obou se aktualizuje index pro odpovědi a volitelně se obsah odebírá do knihovny jako koncept — stažený text, který se změnil sám od sebe, nikdo neschválil, proto každá změna jde schválením. Crawler je jen čtečka: čte a parsuje obsah sledované adresy nebo feedu; každý web potřebuje crawler podle své stavby. První sledovaný web je Slov-Lex s crawlerem statického portálu; crawler pro RSS připravujeme.
MCP konektory — živý zdroj
Organizace se připojí k MCP serveru (první je dokumentace Sportnetu a ISSF) přes OAuth; tokeny jsou uloženy šifrované. Ve výchozím stavu se při otázce hledá jen v knihovně; konektor si člověk zapne pilulkou pod otázkou, nebo ho správce nastaví jako výchozí. Pak se hledá souběžně v knihovně i na serveru, úseky ze serveru se připojí za knihovnu a citace z něj nese štítek „živý zdroj — neověřeno kurátorem“. Když server nestihne, odpověď přijde bez něj. Přístupová úroveň je vlastnost konektoru: interní se do návrhů e-mailů ani do widgetu nedostane. Rozsah serveru se vybírá per kanál a každé volání má stopu bez znění otázky. Druhé použití je import: kurátor vyhledá články na serveru a uloží je jako koncepty dokumentů s PDF; dál jdou běžným schválením a dokument si pamatuje zdroj, takže lze zkontrolovat, zda se článek na serveru změnil. Nástroje asistenta (model volá server sám) připravujeme.
Contineo jako MCP server
AI asistent člověka (Claude Code, Claude.ai, vlastní agent) se připojí na https://<doména organizace>/mcp. Contineo je chráněný zdroj i autorizační server: člověk se přihlásí jako na webu, odsouhlasí rozsahy a souhlas se uloží jako důkazní záznam. Token platí hodinu, obnovovací 30 dní; ukládá se jen jeho otisk. Nástroje fáze 1: whoami, list_sources, search_library, list_documents, get_document, document_hierarchy, list_law_acts, get_law_act a ask (strop 60 za hodinu); search_library a ask berou zdroje z registru. Strop úseků pro každý zdroj nastaví organizace. Přihlášení funguje i z Claude Code (návrat na loopback). Správce osob vidí připojené aplikace všech a smí odpojit komukoli; organizace může omezit MCP na veřejný obsah. Koncepty a kontrolu souladu přes MCP připravujeme.
Legislativa — katalog ze Slov-Lexu
Předpisy ze Slov-Lexu jsou v jednom katalogu platformy (úřední dílo, jedna kopie pro všechny organizace): všechna znění z historie i vyhlášená předem, § jako úsek, stejný embedding jako knihovna. Organizace si ve Zdroje → Web / RSS → Slov-Lex vybere předpisy adresou, číslem nebo z nabídky pro sportovní organizaci; od té doby je Legislativa zdroj na Zeptat se se štítkem Zákon a odkazem na paragraf. Odběr do knihovny vezme text z katalogu a ze Slov-Lexu už jen závazné PDF; zveřejněný dokument má při odpovědi přednost. Denní cron doplňuje znění a pro dokumenty knihoven zakládá koncepty nových znění s upozorněním správcům.
Bezpečnost a provoz
- Přístup podle příslušnosti k organizaci: veřejný obsah vidí každý přihlášený, interní jen lidé dané organizace. Kdo smí nahrávat obsah, se povoluje ručně. Audit při každé změně znalostí.
- Přihlášení e-mailovým odkazem nebo přes SSO: Microsoft Entra ID a Google Workspace. Bez přihlášení se dnes k obsahu nedostanete — veřejný anonymní režim připravujeme.
- Citace verze v každé odpovědi a archivace starých verzí předpisů.
- Monitoring kvality: skóre vyhledávání, hodnocení „sedí / nesedí“ a nahlášené nepřesnosti — kvalita se měří z provozu, ne z testovací sady.
- Multi-tenant: každá organizace je oddělený prostor a vidí jen vlastní obsah — i ten veřejný. Sdílení v hierarchii (centrála → regionální → lokální jednotky) připravujeme.
- Soukromí dat: obsah zůstává ve vaší databázi a úložišti; AI odpovídá výhradně z vašeho obsahu (RAG), veřejná spotřebitelská AI se nepoužívá.
- Volba provozního režimu na úrovni tenanta: cloud (databáze v EU) nebo plně on-prem — obsah ani dotazy neopustí vaši infrastrukturu. Jedna instalace obslouží oba typy zákazníků současně.
- Klíč k AI a modely si organizace může nastavit sama; klíč se ukládá zašifrovaný. Každé volání AI se zapíše do přehledu spotřeby — bez znění otázky, která může obsahovat osobní údaje.
- Výsledek z MCP konektoru je pro model obsah, ne pokyn. Profil serveru odstraní z odpovědi to, co tam nepatří — u Sportnetu blok s profilem přihlášené osoby a pokyny pro model.
- Contineo jako MCP server vydává token samo; souhlas je důkazní záznam, ukládá se otisk tokenu, ne token. Nástroje nikdy nezveřejní znění, nepotvrdí normu, neodešlou zprávu ani nespustí placený běh. V on-prem a air-gap nelze server zapnout.
- Důkazní záznamy (potvrzení, přidělení, schválení) se nemění ani nemažou. Oprava je nový záznam, odvolání má důvod a autora.
Identita a řízení přístupu
Přihlášení přes existující SSO; přístupové právo je povinný filtr odvozený ze session a aplikovaný na obě větve hybridního vyhledávání ($vectorSearch i $search).
Poskytovatelé identity (NextAuth) → jedna kanonická session
| E-mailový odkaz | přihlášení bez hesla; používá se i na pozvánky |
| Microsoft Entra ID | SSO pro firemní účty zaměstnanců |
| Google Workspace | SSO (alternativa) |
| CRM / API zdroje identity — připravujeme | zdroj pravdy o osobách a organizačních jednotkách; mapování na companyCode, role a skupiny |
Principy bezpečnosti
- Server-side only — filtr se skládá ze session, nikdy z parametrů klienta.
- Default-deny — co není výslovně povoleno, se nevrátí; bez identity jen veřejný obsah.
- Filtr před LLM — model vidí jen povolené chunky; nedá se obejít promptem (platí i pro citace).
- Auto-provisioning — osoba se založí při prvním přihlášení přes SSO z domény povolené organizací. Průběžnou synchronizaci rolí z CRM připravujeme.
Dva typy kanálu
Portál (interní, SSO)
přihlášený člověk vidí veřejný i interní obsah své organizace — knihovna, asistent, potvrzování, vzdělávání. Články a formuláře pro portál připravujeme.
Widget s podepsanou identitou
cizí systém (první je ISSF) předá identitu uživatele podepsaným tokenem; widget odpovídá z obsahu kanálu a po dvou negativních hodnoceních otevře ticket. Osoba z tokenu se do intranetu nepřihlásí. Anonymní veřejný režim připravujeme.
Nasazení ve velké organizaci — sportovní svaz (SFZ)
Contineo je doménově univerzální. Takto vypadá jedno reálné nasazení do velké organizace — Slovenského fotbalového svazu a jeho podřízených svazů.
- Tenant model: SFZ, regionální a oblastní svazy jako samostatné organizace s vlastním obsahem; sdílení norem shora dolů připravujeme.
- Obsah: soutěžní a přestupní řády, rozpisy soutěží, směrnice, manuály ISSF (doplňované z otázek helpdesku).
- Identita: přihlášení e-mailovým odkazem, přes Microsoft Entra ID nebo Google Workspace; osoby naimportované ze seznamu a pozvané e-mailem, role se přidělují v aplikaci. Napojení na sportnet.online jako zdroj členství je další krok.
- Potvrzování ověřené naostro: přidělení osobě, oddělení i trase, výzva e-mailem, potvrzení z počítače i z telefonu a výkaz pro personální oddělení.
- Vzdělávání: kurzy, testy a certifikáty s ověřením přes QR kód.
- Příklad otázky: „Může hráč nastoupit ve dvou utkáních za jeden den?“ → odpověď s citací § a verze.